同一种表征,能否服务不同的 fMRI 研究?
一段 fMRI 扫描包含大量位置上的信号。常见做法是先在预定义脑区(ROI)内取平均,把输入压缩成脑区时间序列。但空间边界也因此在学习前就被固定:两个相邻、响应不同的体素可能被合成一个均值,换一种图谱,模型接收到的信息也会改变。
Omni-fMRI 希望先学到可复用的体素表征,再将它适配到人口学预测、疾病相关分类和任务解码等研究中。这样,每个数据集或每种图谱不必从头建立一套特征。难点在于计算量:如果所有位置都切成同样小的 patch,token 序列会非常长。
保留体素信息,让计算量随内容调整
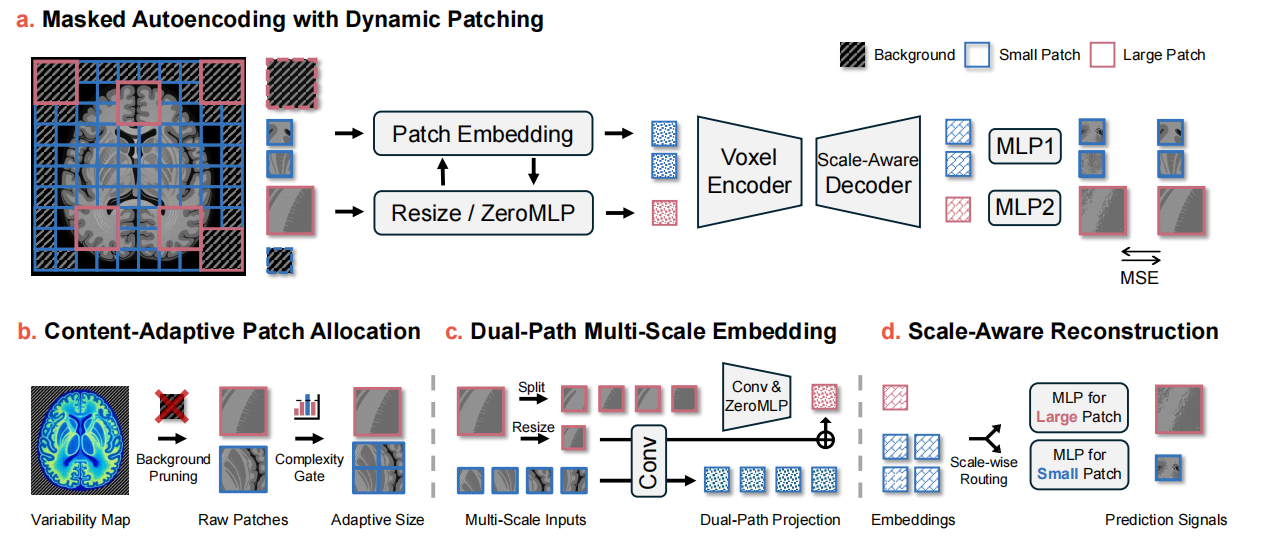
输入是四维 fMRI 体积,而不是 ROI 均值列表。上方原文方法图依次展示三件事:确定 patch 尺度、嵌入不同尺度的 patch、重建被掩蔽的信号。预训练后,再将编码器特征接入对应任务的预测头。
在信号变化较大的位置保留细节
Dynamic patching 先移除非脑背景,再计算局部时空强度方差。低方差区域用较大的 patch 表示,高方差区域继续细分。这样,模型不必在所有位置投入同样多的 token。决定精细程度的是信号变化,而不是预先划定的解剖脑区。
让不同尺度共享一个编码器
双路径嵌入将大 patch 的下采样视图与内部小 patch 的特征结合,再把粗、细 token 映射到同一潜空间,交给 ViT 编码器。不同尺度因此具有统一的特征接口,同时保留位置与尺度信息。
避免大 patch 主导重建目标
Masked autoencoding 根据可见上下文预测被遮挡的 fMRI 信号。不同尺度使用各自的重建头,损失还考虑 patch 体积与 token 数量。否则,大 patch 可能仅因包含更多体素,就在训练目标中占据更大权重。
先换数据集,再冻结编码器,检验表征能否复用
预训练包含 9 个数据集、49,497 次扫描。11 个评估数据集并非都属于外部测试:其中 4 个来自预训练数据源的独立评估划分,另外 7 个未参与预训练,分别是 ADNI、SALD、BHRC、NKI、NSD、HCP task 和 StudyForrest。后者检验模型面对新数据源或不同实验设置时的迁移能力。
为不同任务提供共同起点
同一个预训练编码器被适配到年龄回归、疾病相关预测、视觉图像检索,以及脑状态或情绪预测。目标和数据集同时变化,实验因而能检验特征的可复用性。这些结果来自下游适配,并非未经训练的 zero-shot 预测。
不更新编码器,特征仍然有用吗?
Linear probing 冻结编码器,只训练轻量预测头。在 ADNI 的 AD 分类中,Omni-fMRI 的准确率为 84.26%,NeuroSTORM 冻结编码器的结果为 71.64%。这一设置更直接检验预训练表征中已经包含的信息。整体微调表现较强,但并非每一个指标都排在首位。
| 数据集 / 任务 | 评估方式 | Omni-fMRI | 对比结果 |
|---|---|---|---|
| ADNI · AD 分类 | 整体微调 · ACC ↑ | 88.77 ± 0.71% | NeuroSTORM · 84.26 ± 0.80% |
| ADNI · AD 分类 | 冻结编码器 · ACC ↑ | 84.26 ± 0.87% | NeuroSTORM · 71.64 ± 0.66% |
| NSD · 100 候选图像检索 | 整体微调 · Top-10 ↑ | 23.08 ± 1.93% | NeuroSTORM · 20.83 ± 1.65% |
共享特征接口,不预先固定 ROI 边界
核心思路是共享表征,同时允许下游目标变化。Dynamic patching 降低体素级学习的成本,未参与预训练的数据集与 linear probing 则从不同角度检验复用价值。这里的 atlas-free 指不依赖预定义 ROI 分区;研究仍在训练前统一空间与时间采样。
从项目主页开始,提取自己的 fMRI 特征
官方项目主页集中展示方法、基准结果和可运行的 quick start。仓库接受整理为 96 × 96 × 96 × 40 的 NPZ 输入,输出全局 cls_token、patch_tokens 与 patch_coords。可以先运行合成数据 smoke test 或 notebook,再按文档准备自己的扫描数据。
A Universal Atlas-Free fMRI Foundation Model
本文由 fMRI Atlas 根据上述原始研究整理。
本文更新:
阅读原文摘要(英文)
Self-supervised fMRI foundation models have shown promising transfer performance, yet most rely on predefined region-level parcellations that discard fine-grained voxel information and introduce atlas-dependent biases. We propose Omni-fMRI, an atlas-free foundation model that operates directly on voxel-level signals. To enable scalable pretraining on 49,497 fMRI sessions across nine datasets, Omni-fMRI introduces a dynamic patching mechanism that substantially reduces computational cost while preserving informative spatial structure. To support reproducibility and fair comparison, we establish a comprehensive benchmark suite spanning 11 datasets and a diverse set of resting-state and task-based fMRI tasks. Experimental results demonstrate that Omni-fMRI consistently outperforms existing foundation models, providing a scalable and reproducible framework for atlas-free brain representation learning.
BibTeX
@article{wang2026omnifmri,
  title={Omni-fMRI: A Universal Atlas-Free fMRI Foundation Model},
  author={Wang, Mo and Ye, Wenhao and Xia, Junfeng and Zhang, Junxiang and Pan, Xuanye and Xu, Minghao and Deng, Haotian and Wen, Hongkai and Liu, Quanying},
  journal={arXiv preprint arXiv:2601.23090},
  year={2026},
  url={https://arxiv.org/abs/2601.23090},
  doi={10.48550/arXiv.2601.23090}
}